
AX:用 Kubernetes 的方式编排 AI Agent
最近 Google 在 GitHub 上低调开源了一个新项目 AX(Agent Executor / Agentic Orchestrator),口号:
一个高吞吐、声明式的编排器,用来在集群里运行数十亿个自治 Agent 工作负载。
为什么需要 AX:Agent 是一种新型工作负载
AX 的 README 开篇就点明了主旨:Agent 既不是无状态微服务,也不是跑完即退的批处理任务。它们有几个让传统基础设施头疼的特点:
有状态:Agent 在生命周期内不断积累上下文、文件、中间结果,不能随便重启;
要隔离:Agent 会执行模型生成的不可信代码,必须有沙箱和资源限额;
常发呆:等模型返回、等工具调用、等人工确认,90% 以上的时间是空闲的——但状态必须留着;
会花钱:一个陷入循环的 Agent 可以不停调用模型 API 直到账单爆炸。
Kubernetes 擅长管理无状态服务,也能管理 Job 之类的有状态任务,但是 Agent 工作负载稍有区别。AX 的思路是:把 Agent 任务变成一条可以 apply、可以观察、可以挂起、可以恢复的集群工作负载,就像 kubectl 运行容器化工作负载一样。
为此 AX 站在另一个 Google 开源项目 Agent Substrate 的肩膀上:Substrate 负责底层的沙箱执行与状态快照,AX 负责上层的声明式编排。两者都是 Apache-2.0 协议,都处于 pre-1.0 阶段(API 随时可能大变,官方 README 专门加了粗体警告)。
组件与功能
先看一张整体组件关系图:
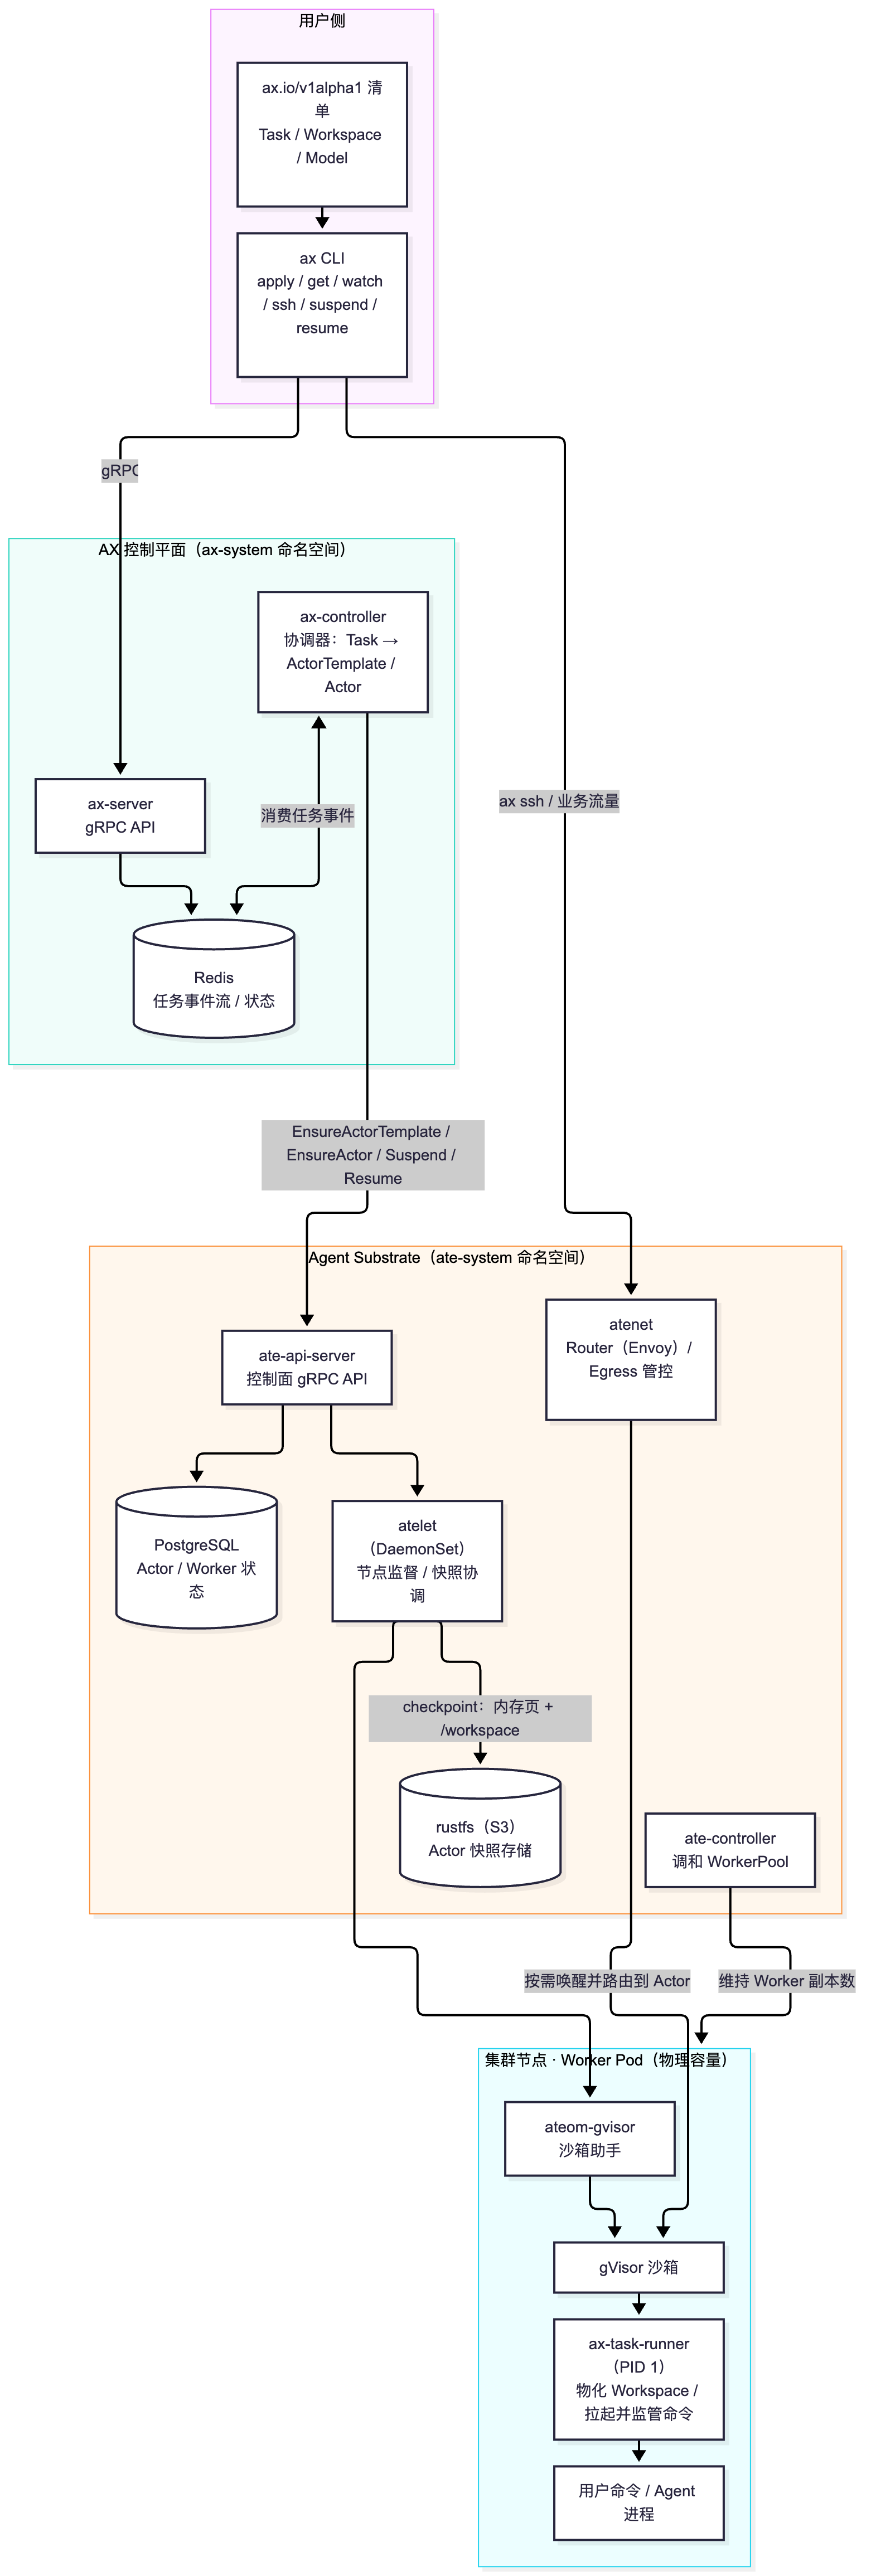
AX 层:三个声明式原语 + 一个 kubectl 风格的 CLI
所有资源都用 ax.io/v1alpha1 的 YAML 清单描述,通过 ax apply -f 提交,体验和 Kubernetes 几乎一致。
Task —— 最小隔离执行单元
声明容器镜像、启动命令、CPU/内存请求与上限、环境变量,以及要挂载的 Workspace。每个 Task 都在独立沙箱里运行,是"便宜到可以随时创建、隔离、挂起、丢弃"的基本单元。一个 Agent 可以只用一个 Task,也可以在拆解问题时派生出一棵 Task 树——每个节点获得相同的沙箱和生命周期语义。
Task 的生命周期用 status.phase(Running / Suspended / Failed / Terminating…)和 Conditions(WorkspaceReady、Ready)表达,可以用 ax watch 实时观察。
** Workspace —— 让 Agent "热启动"的环境声明**
Agent 开始干活前的准备工作很繁琐:克隆指定分支的代码仓库、配置允许调用的 MCP 服务器、安装技能包(Skills)。Workspace 把这一切声明化:声明一次,被任意多个 Task 引用,运行器(Runner)会在命令启动前把环境物化到沙箱里。
有趣的是 goal 字段:你可以用自然语言描述想要的环境(例如"确保 Go 工具链从源码构建完成"),首次启动时会由一个内置 Agent 自动完成环境搭建。
Model —— 模型供应商配置
声明用哪家供应商、哪个模型、生成参数,以及存放凭证的 Kubernetes Secret。把模型配置变成集群资源后,换密钥、锁版本、调参数都只需要一次 ax apply,而不是翻遍每个 Agent 的环境变量。AX 自己的组件(比如执行 Workspace goal 的引导 Agent)也读 Model 资源。
ax CLI —— kubectl 风格的操作面
apply / get / describe / watch / delete 之外,还有几个 Agent 特色的动词:
ax suspend task <name>—— 对 Actor 做检查点(checkpoint),挂起并释放算力;ax resume task <name>—— 从快照精确恢复到挂起前的状态;ax ssh <name> -- <cmd>—— 直接 shell 进运行中的沙箱"围观"Agent 在干什么(需要 Task 声明debug: true);ax ctx/ax tunnel—— CLI 通过 gRPC 连接控制面,跟随当前 kube context 自动建隧道。
控制平面组件
部署在 ax-system 命名空间里:
ax-server:gRPC API 服务,CLI 的所有请求都打到这里;
ax-controller:核心协调器,把 Task 翻译成 Substrate 的 ActorTemplate 和 Actor,驱动挂起/恢复,轮询沙箱的就绪探针;
Redis:任务事件流与状态存储;
ax-task-runner:每个 Task 容器里的 PID 1。它是控制面和"Agent 实际进程"之间的桥梁——负责物化 Workspace、启动并监管用户命令、暴露
/healthz/readyz和元数据服务,debug: true时还提供 guest services(ax ssh走的就是它)。你可以换成自己的 runner 镜像,只要遵守同样的契约。
Agent Substrate 层:沙箱执行与高密度复用
Substrate 的核心洞察是:Agent 大部分时间在 idle,因此可以把大量"Actor"(有状态的 Agent 进程)多路复用到少量"Worker"(物理 Pod)上。官方演示里,250 个有状态 Actor 只跑在 8 个物理 Pod 上,挂起/恢复做到亚秒级。
主要组件(部署在 ate-system 命名空间,ate 是 Agent Task Execution 的缩写):
ate-api-server:控制面 API(gRPC),管理 Actor/Worker 生命周期,状态存在 PostgreSQL;
ate-controller:Kubernetes 控制器,调和
WorkerPool自定义资源(Worker 池的副本数、镜像、资源);atelet:节点级 DaemonSet,监督本节点的 Worker Pod、协调快照与状态迁移;
atenet:网络层(基于 Envoy 的 router + egress 代理),负责把流量路由到"此刻正好醒着"的 Actor,必要时先唤醒再转发(request parking);
ateom-gvisor / ateom-microvm:跑在 Worker Pod 内部的沙箱助手,分别用 gVisor 和 microVM(Cloud Hypervisor)执行 Actor,负责
runsc的检查点/恢复;podcert-controller:为 Pod 证书签发提供 polyfill(该能力未来会进入上游 Kubernetes);
rustfs:S3 兼容对象存储,保存 Actor 的快照(挂起时内存页和文件系统的镜像)。
沙箱隔离默认用 gVisor(有 KVM 的机器上可用 microVM),Actor 出网流量受 egress 策略管控——用来防止烧钱。
一个 Task 的旅程:从 ax apply 到挂起恢复
把两层串起来,一个 Task 从下发到执行、再到挂起恢复的完整流程如下(对应本文实测的每一步):
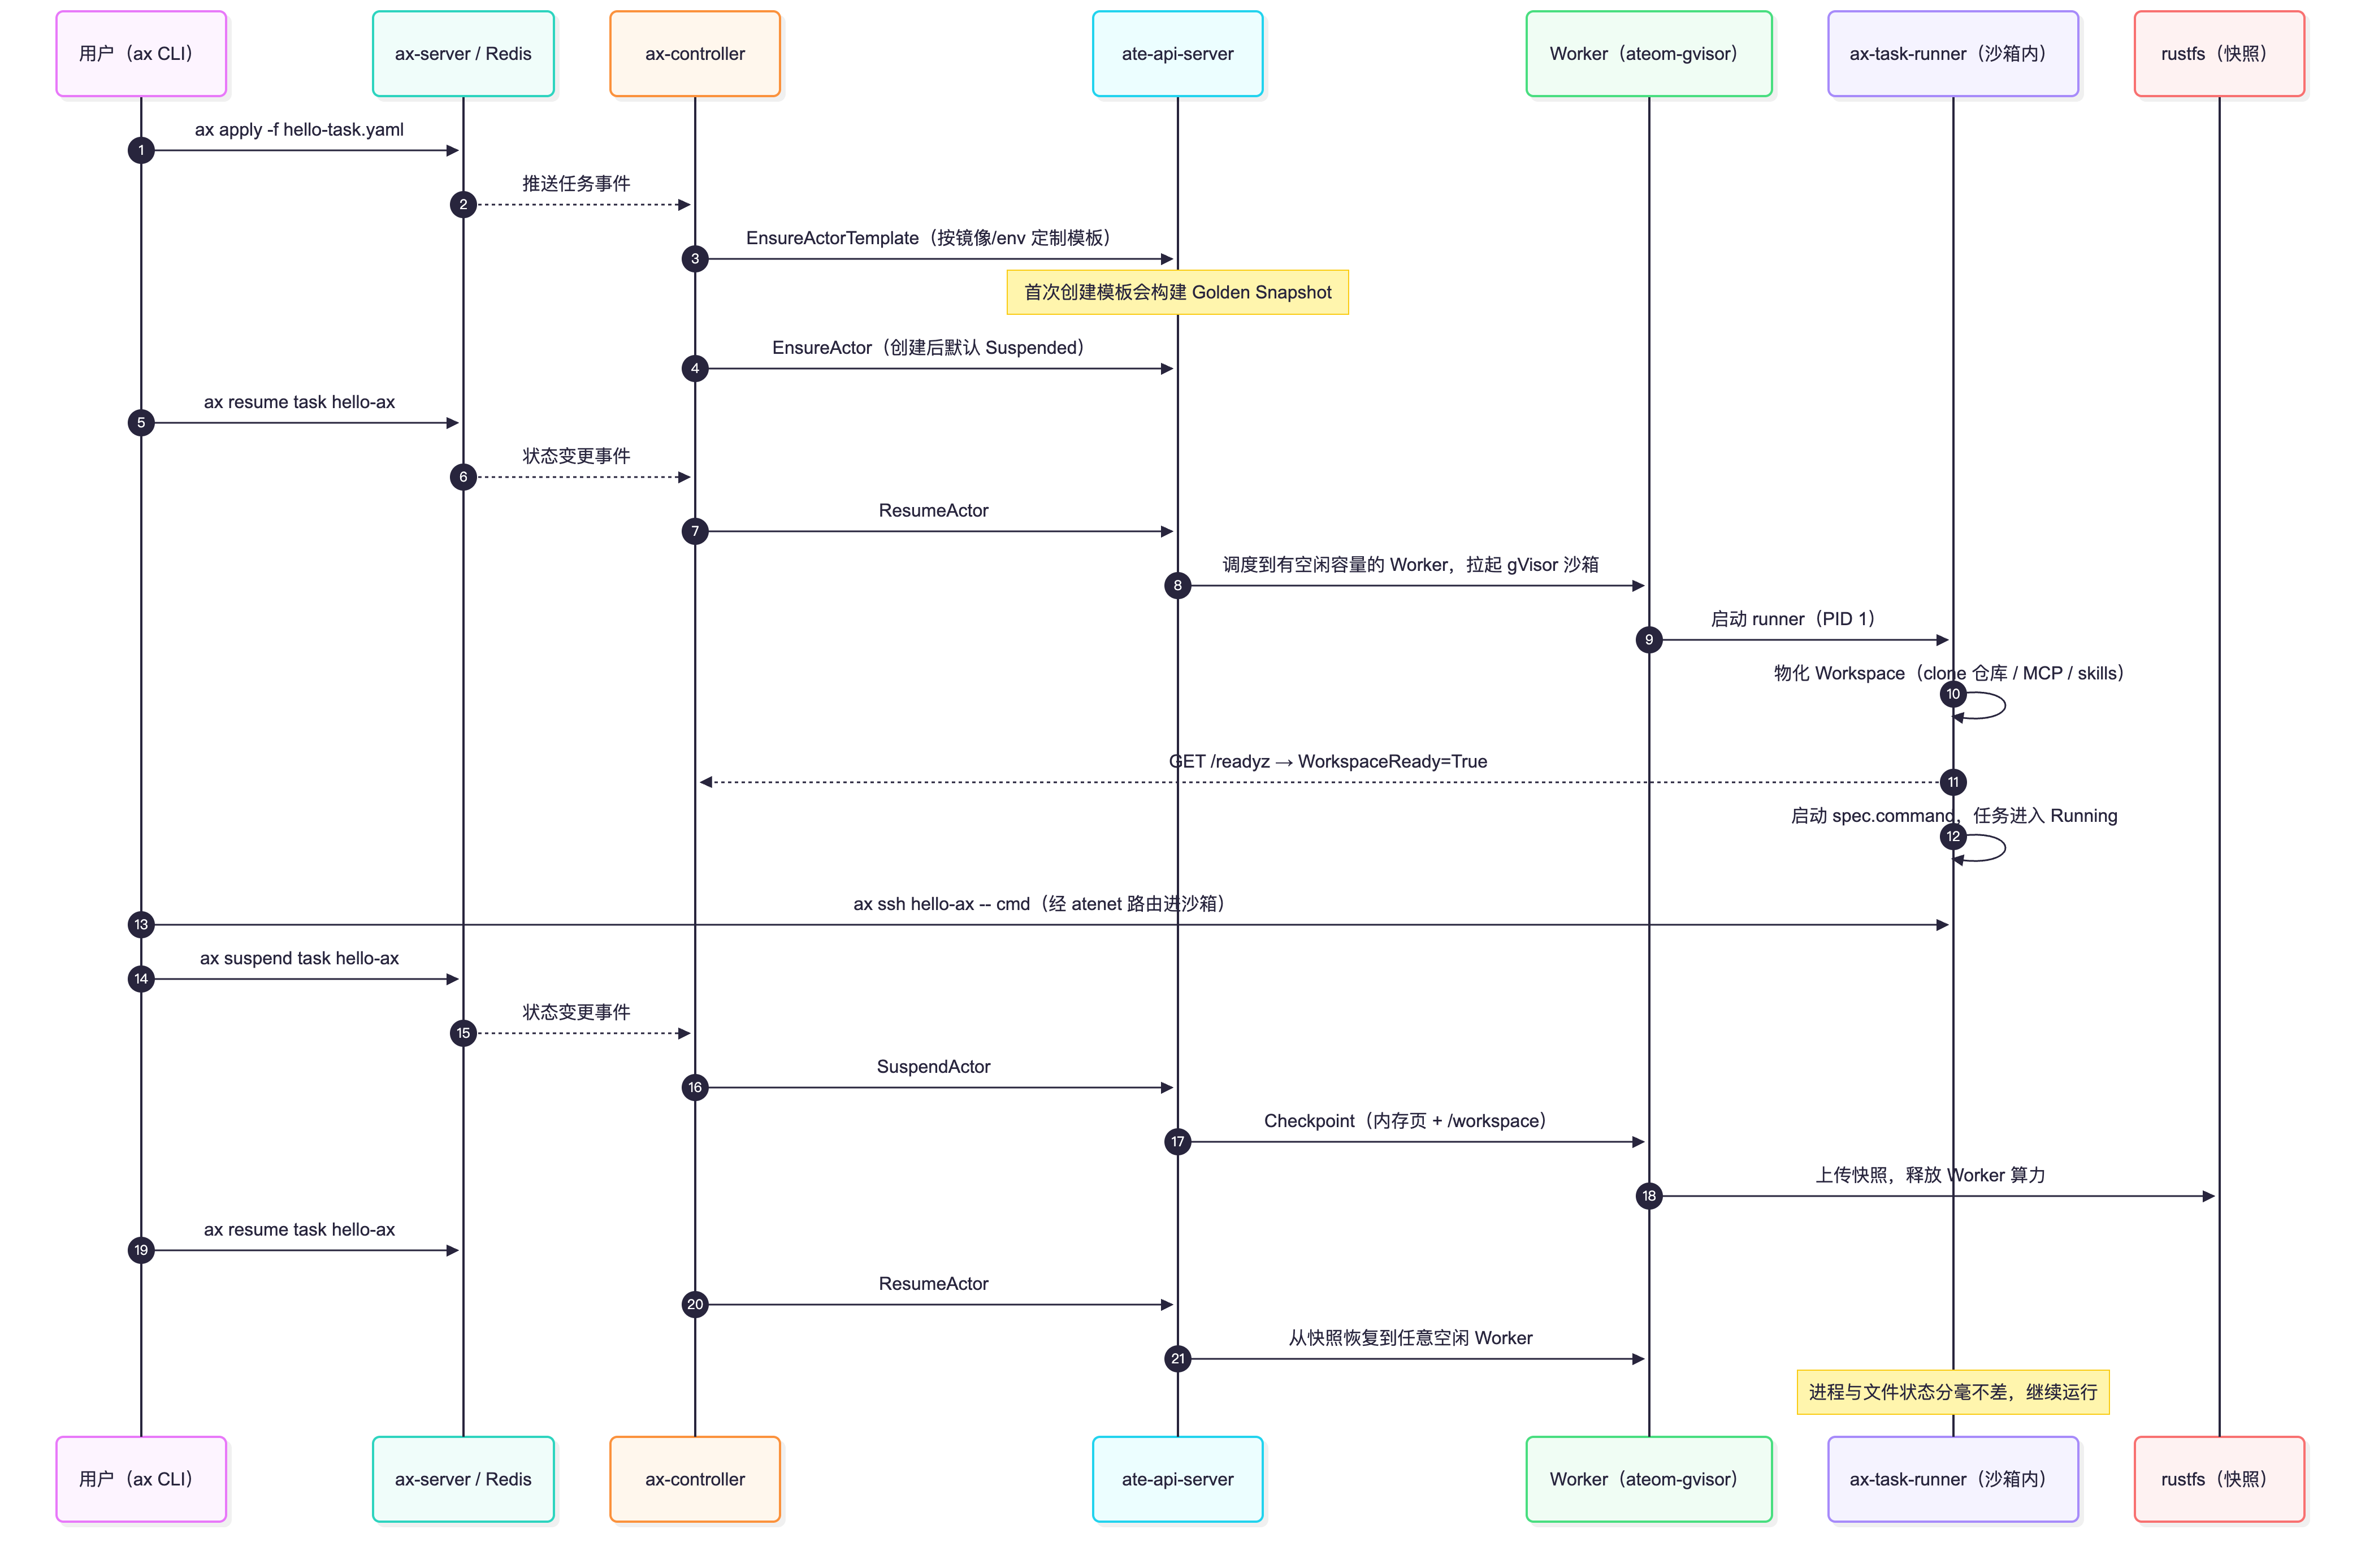
几个值得注意的细节:新 Task 创建后默认是 Suspended,要显式 ax resume 才会占用 Worker——这正是“为 idle 而生“的设计;挂起后快照落在对象存储里,恢复时可以调度到任何一个有空闲容量的 Worker 上(Actor Teleport),不必回到原节点。
本机实测:在 macOS 上跑通 Hello World
测试环境
MacBook(Apple Silicon / arm64),Docker(OrbStack)运行中
Go 1.27.1、kubectl v1.37、
kov0.19.1(brew install ko)本地 K8s 用 kind(v1.37.0 节点),无需 GCP
ko 是 Google 开源的 Go 容器镜像构建工具:不需要写 Dockerfile,
ko build ./cmd/myapp就能把 Go 二进制打进一个极简基础镜像并推送到 registry;它还认得 YAML 里的ko://github.com/xxx/cmd/app镜像引用,ko apply/ko resolve会自动构建、推送并改写成真实镜像 digest 后再提交给集群。可以理解为"Go 项目的 docker build + push + kubectl apply 合一体",Knative 等 Google 系项目都在用。AX 和 Substrate 的所有组件镜像都是靠它构建部署的。
拉起 kind 集群并安装 Agent Substrate
Substrate 自带了本机开发脚本,一条命令创建 kind 集群 + 本地镜像 registry(端口 5001):
git clone https://github.com/agent-substrate/substrate.git
cd substrate
hack/create-kind-cluster.sh
hack/install-ate-kind.sh --deploy-ate-system
脚本会用 ko 从源码构建 ateapi、atelet、atenet 等组件镜像推入本地 registry,再部署 PostgreSQL、rustfs 和全套控制面。装完验证:
$ kubectl get svc api -n ate-system
NAME   TYPE        CLUSTER-IP   EXTERNAL-IP   PORT(S)   AGE
api    ClusterIP   None         <none>        443/TCP   45m
部署 AX 控制平面
git clone https://github.com/google/ax.git
go install github.com/google/ax/cmd/ax@latest   # 安装 CLI
cd ax
make deploy AX_IMAGE_REPO=localhost:5001/ax     # ko 构建并部署 ax-server / ax-controller / Redis
创建 WorkerPool
这是一个 README 没写清楚的步骤:AX 的 Task 最终要调度到 Substrate 的 Worker 上,而新集群里没有任何 WorkerPool,直接跑任务会报 no free workers available。参照 Substrate 的 counter 示例,为 default 命名空间建一个 gVisor WorkerPool:
# workerpool.yaml
apiVersion: ate.dev/v1alpha1
kind: WorkerPool
metadata:
  name: ax-workers
  namespace: default
spec:
  replicas: 1
  workerImage: ko://github.com/agent-substrate/substrate/cmd/ateom-gvisor
  template:
    nodeSelector:
      ate.dev/substrate-version: "1d7ca8c"   # 与安装时节点打的版本标签一致
    resources:
      limits:   { cpu: "2",  memory: 2Gi }
      requests: { cpu: 250m, memory: 2Gi }
用 ko resolve 构建 ateom-gvisor 镜像并一并提交:
cd substrate && KO_DOCKER_REPO=localhost:5001 ko resolve -f ../workerpool.yaml | kubectl apply -f -
自建 task-runner 镜像
官方示例里的任务镜像 gcr.io/ax-substrate/ate-images/ax-task-runner 匿名拉取会被拒绝(403,该仓库未公开),所以本机自建一份。注意两点:kind 节点是 arm64,Makefile 里硬编码了 amd64,需要改;Substrate 要求 Actor 镜像必须用 digest 固定(镜像变了快照就失效):
cd ax
GOOS=linux GOARCH=arm64 CGO_ENABLED=0 go build -trimpath -ldflags="-s -w" \
  -o bin/linux_arm64/ax-task-runner ./cmd/ax-task-runner
sed 's|bin/linux_amd64|bin/linux_arm64|' Dockerfile.task-runner > /tmp/Dockerfile.arm64
docker build --platform linux/arm64 -t localhost:5001/ax-task-runner:latest -f /tmp/Dockerfile.arm64 .
docker push localhost:5001/ax-task-runner:latest
(localhost:5001 会被 Substrate 的镜像缓存自动改写成集群内的 kind-registry:5000,无需手动处理。)
声明并运行 Hello World
最小的 Task——不带 Workspace 和 Model,开 debug 以便 ssh:
# hello-task.yaml
apiVersion: ax.io/v1alpha1
kind: Task
metadata:
  name: hello-ax
  atespace: default
spec:
  image: "localhost:5001/ax-task-runner@sha256:8cf61d06…"   # digest 固定
  env:
    - name: GREETING
      value: "Hello from AX!"
  debug: true
ax apply -f hello-task.yaml
ax resume task hello-ax        # 新 Task 默认是 Suspended,需要显式 resume
ax get tasks
NAME       ATESPACE   PHASE     ACTOR      WORKER-IP     AGE
hello-ax   default    Running   hello-ax   10.244.0.25   1m
ax describe 可以看到 Ready=True (TaskRunning)、WorkspaceReady=True (SetupComplete) 两个条件。
SSH 进沙箱看看
$ ax ssh hello-ax -- sh -c 'echo "$GREETING"; uname -a; ls -la /workspace'
Hello from AX!
Linux actor 4.19.0-gvisor #1 SMP Sun Jan 10 15:06:54 PST 2016 aarch64 GNU/Linux
total 0
drwx------ 1 root root   0 Sep 26 17:04 .
drwx------ 1 root root 100 Sep 26 17:04 ..
注意 uname 的输出:内核是 4.19.0-gvisor——这个 shell 确实跑在 gVisor 沙箱里,而不是普通容器。
挂起 / 恢复
先往工作目录写个文件,然后挂起:
ax ssh hello-ax -- sh -c 'echo "state survives suspend" > /workspace/memo.txt; date >> /workspace/memo.txt'
ax suspend task hello-ax
# PHASE 变为 Suspended,Worker 资源被释放
再恢复,读回文件:
$ ax resume task hello-ax && ax ssh hello-ax -- cat /workspace/memo.txt
state survives suspend
Sat Sep 26 17:11:44 UTC 2026
挂起时 Substrate 对 Actor 做了完整检查点(内存页 + /workspace 文件系统打成快照存入 rustfs),恢复后从断点继续——这正是"Agent 大部分时间 idle"场景的省钱关键:空闲时不占算力,醒来时上下文分毫不差。
M1 踩坑记录
代理传播问题:宿主机 shell 里的
HTTP_PROXY=127.0.0.1:7890会被 kind 传进节点、被 buildkit 传进构建容器,而容器里的127.0.0.1是它自己——所有拉取全部失败。解决:创建集群和构建时把代理指向宿主机真实地址(如192.168.x.x:7890),并把kind-registry加进NO_PROXY。官方 runner 镜像拉不动:示例中的
gcr.io/ax-substrate/ate-images/ax-task-runner未公开,必须自建(且注意 arm64)。镜像必须 digest 固定:用
:latest会被 Substrate 拒绝(must be pinned by digest)。快照 bucket 缺失:AX 控制器默认把快照写到
gs://snapshot-substrate-test-ax-substrate/,而本地 rustfs 只初始化了ate-snapshots桶,导致首次挂起报NoSuchBucket。在 rustfs 里手动建同名桶即可:aws --endpoint-url http://rustfs.ate-system.svc:9000 s3api create-bucket --bucket snapshot-substrate-test-ax-substrateresume 竞态:任务刚创建就 resume,控制器可能先处理创建事件把任务又挂回去;再执行一次
ax resume即可。
总结
AX 的思路很清晰:把沙箱、状态、挂起恢复、网络策略这些工程地基收敛成三个声明式原语和一套 kubectl 风格的工具链,底层由 Agent Substrate 提供高密度复用和亚秒级快照。
它适合的场景是:需要在集群里大规模、可审计、可管控地运行自治 Agent 任务的团队。需要提醒的是,项目目前处于非常早期(pre-1.0,README 明说随时可能有破坏性变更),文档与代码存在脱节(示例镜像私有、WorkerPool 需要自建、默认快照桶名对不上),离生产可用还有距离。但作为观察"Agent 基础设施"演进方向的样本,非常值得动手一试。
参考链接
Agent Substrate:https://github.com/agent-substrate/substrate
概念文档:AX 仓库
docs/concepts.md,Substrate 仓库docs/api-guide.md